アニメ調のキャラクターを作り、同じ人物のまま複数のカットを描けるかを試しました。
結論として、3枚の連作は作れたものの、装飾の細部までは固定できませんでした。ただ今回、それ以上に収穫だったのは、思い通りの画像が出なかったときに、どこを疑えばいいかが整理できたことです。
検証中の失敗は3つありました。モデルの選定、設定値の意味、素材の渡し先で、いずれも出力を見ただけでは原因が分からない種類のものです。中には、うまくいったと思っていた設定が、実は何の働きもしていなかったというケースもありました。
ノードで組み立てるComfyUIでは、こうした切り分けが比較的やりやすいことも分かりました。
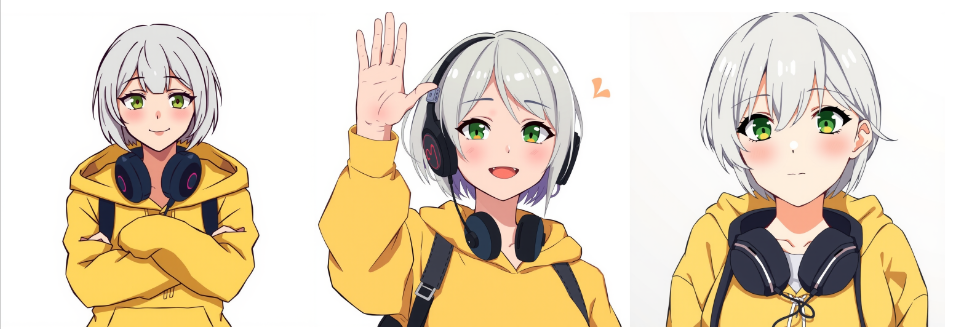
キャプション:最終的に生成した3枚(左から腕組み、手を上げる、立ち姿)。ポーズは指定通りになりましたが、ヘッドホンの細部などは揃っていません。
ノードベースの画像生成AIツール「ComfyUI」を実際に使い、業務に利用できるのかを検証する本企画。
第1回ではComfyUI Desktopを導入して最初の1枚を生成し、第2回では記事のアイキャッチ制作に挑戦しました。第3回ではControlNetを使い、Canny・Depth・OpenPoseで何をどこまで固定できるのかを比較しています。
【入門編】高品質AI画像生成の定番ComfyUI入門! 最初の1枚とワークフローの再現まで試してみた
【実践編】ComfyUIで記事のアイキャッチを制作! 横長構図とタイトル余白を狙ってみた
【実践編】ComfyUIのControlNetで構図を狙う! Canny・Depth・OpenPoseを比較してみた
ここまで扱ってきたのは、いずれも「1枚の画像をどう作るか」でした。
しかし実務では、1枚できれば終わりという場面ばかりではありません。連載記事に同じ案内役キャラクターを登場させる、資料に同じ人物のカットを何枚も使う、といった用途では、複数の画像で同じキャラクターに見え続けることが必要になります。
そこで第4回では、オウンドメディアの案内役キャラクターを想定し、アニメ調のキャラクターを設定したうえで、ポーズを変えた複数枚を作れるかを検証しました。
今回のキャラクター設定と環境
今回の環境はComfyUI Desktop v0.35.1です。
崩れたかどうかを判定しやすいよう、キャラクターの特徴は事前に決めました。
| 項目 | 設定 |
| 年齢感 | 20代半ばの成人女性 |
| 髪 | 銀髪のショートボブ |
| 目の色 | 緑 |
| 衣装 | 黄色のパーカー |
| 装飾 | 大きめの黒いヘッドホン(首にかける) |
| 構図 | 上半身、正面、1024×1024 |
実際に使ったプロンプト(英語)は次の通りです。以降の検証では、ポーズと表情の記述だけを差し替えています。
立ち姿(基本)
anime style, upper body portrait of an adult woman, front view, looking at viewer, neutral expression, short silver hair, bob cut, green eyes, yellow hoodie, large black headphones around neck, simple white background, clean line art, cel shading, flat colors, no text, no logo, no watermark
なお本連載では、実在の作家・版権キャラクター・実在人物を狙う使い方はしません。設定を決める際も、特定の既存キャラクターを連想させる配色や組み合わせは避けています。
プロンプトを直しても直らないなら、モデルを疑う
最初に使ったのは、第3回で使用したStable Diffusion v1.5(v1-5-pruned-emaonly)です。ControlNetなど周辺機能の対応が広く、ライセンスの確認も済んでいました。
ところが、生成結果は設定と大きく違うものになりました。
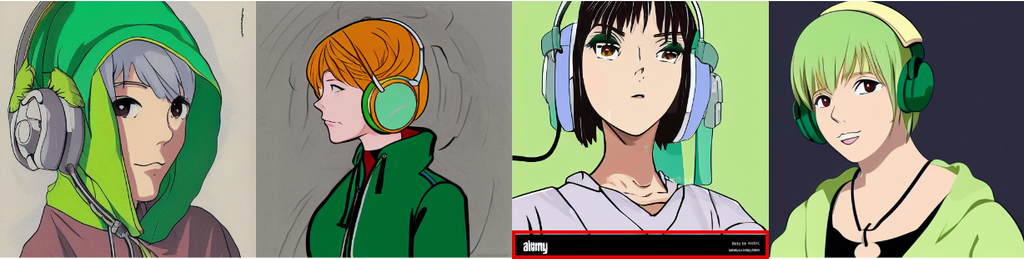
キャプション:同じプロンプトでseedだけを変えた4枚。指定した髪色や衣装がほとんど反映されていません。左から3枚目の下部(赤枠)には、指定していないストック写真サービスの透かしが生成されています(後述)。
指定通りに出たのはヘッドホンくらいで、髪色は毎回変わります。目立ったのは、指定した色が別の部位に移る現象でした。「オレンジの裏地」と書けば髪がオレンジになり、「緑の目」と書けば髪や背景まで緑に寄ります。
ここでまず、プロンプト側を疑いました。装飾の指定を減らし、色がぶつからない組み合わせへ書き換え、文章も短く整理しています。
それでも結果は変わりませんでした。安定したのは相変わらずヘッドホンだけです。
プロンプトを2度書き直しても改善しなかったため、原因はプロンプト以外にあると考えました。そこでモデルそのものを疑い、第1〜2回で使っていたFLUX.1 Schnell FP8へ切り替えています。
このとき重要なのは、変えるのはチェックポイントだけという点です。ComfyUIでは「チェックポイントを読み込む」ノードのファイル名を差し替えるだけで済みます。プロンプトは一字も変えず、SD1.5で使った最終版をそのまま渡しました。比較したいのはモデルの違いだけだからです。
複数のモデルファイルを置いておけば、こうした比較はプルダウンの操作だけで済みます。プロンプトを書き直しながら粘るより、同じ条件のままモデルを入れ替えて出力を見比べるほうが早い場面がある、というのが今回の実感でした。
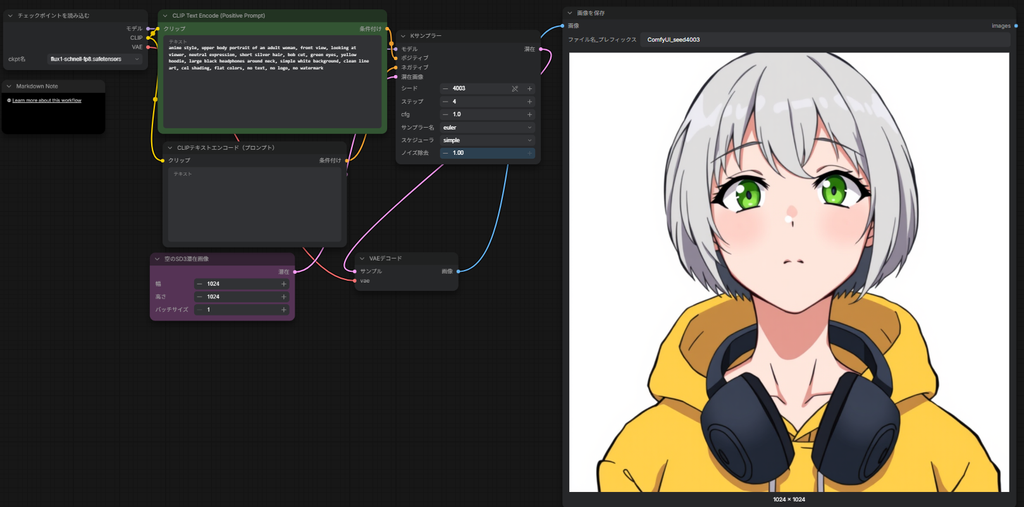
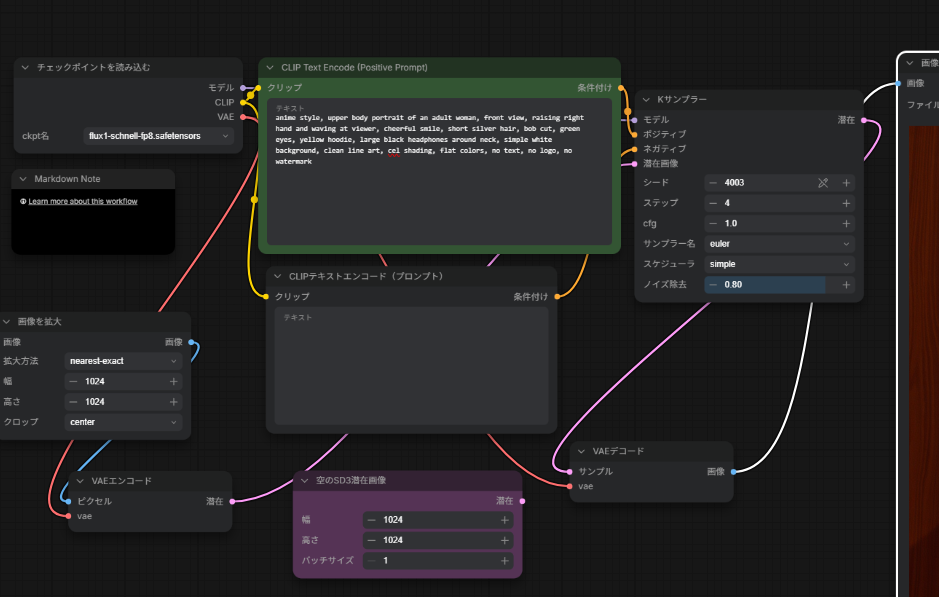
キャプション:FLUX.1 Schnellに切り替えたワークフロー。変えたのはckpt名だけです。右の出力は、後に基準キャラクターとしたseed 4003のものです。
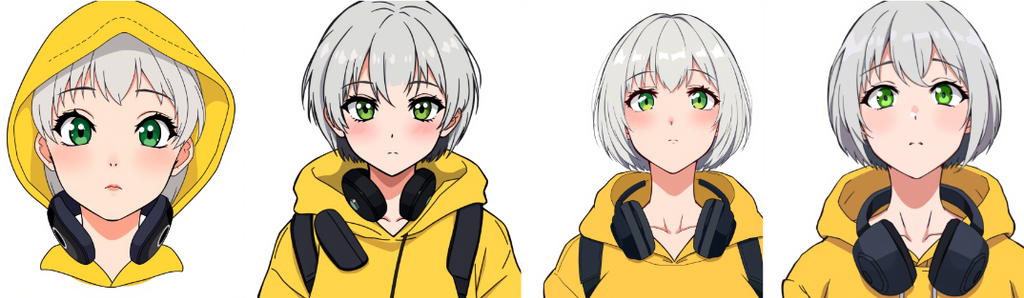
キャプション:同じプロンプトをFLUX.1 Schnellへ渡した結果。銀髪ボブ、緑の目、黄色のパーカー、黒いヘッドホンがすべて反映されています。
4枚とも指定した特徴がそろい、seedが違っても「同じ設定の人物」に見えます。
差が出た理由の1つとして、プロンプトを読み取る仕組み(テキストエンコーダー)の違いが考えられます。SD1.5が使うのはCLIPだけで、色と部位の対応を取り違えやすいことが以前から指摘されています。一方で、FLUX.1はCLIPに加えて、長い文章の読解に強いT5も併用しています。
なお、FLUX.1 SchnellはCFG 1.0で使う前提のモデルのため、ネガティブプロンプトは実質的に働きません。そこでネガティブ側は空欄のままにし、避けたい要素は「no text, no logo, no watermark」としてポジティブ側に書きました。ただし否定形の指示が必ず守られるわけではなく、後の検証では意図しない文字が描かれています。
一方、別の課題も現れました。プロンプトに書いていないリュックの肩ひもやフードが複数の画像に出ています。指示が守られるようになった分、今度は「書いていないもの」の扱いが問題になるという形です。
余計な要素がなく特徴がはっきり見えるseed 4003を、以降の基準キャラクターとしました。ただし、この画像を後の工程へ入力として渡すことはしていません。ほかのカットが同じ人物に見えるかを判定するための、見た目の基準としてのみ使っています。
ここでの教訓は、キャラクターを扱う用途では、プロンプトの工夫と同じかそれ以上にモデル選定が効く、ということです。比較したのはSD1.5の素のモデルとFLUX.1 Schnellの1組だけですが、プロンプトをいくら直しても動かなかった結果が、モデルの差し替えだけで大きく変わりました。第3回までは周辺機能の対応範囲でモデルを選んでいましたが、用途によって優先順位は変わります。
ポーズを変えると、動きの大きいものから崩れる
基準キャラができたので、次はポーズを変えます。
まずプロンプトだけで試しました。キャラクター設定はそのままに、ポーズと表情の記述だけを次のように差し替えています。
手を上げる
anime style, upper body portrait of an adult woman, front view, raising right hand and waving at viewer, cheerful smile, short silver hair, bob cut, green eyes, yellow hoodie, large black headphones around neck, simple white background, clean line art, cel shading, flat colors, no text, no logo, no watermark
腕組み
anime style, upper body portrait of an adult woman, front view, arms crossed over chest, slight confident smile, short silver hair, bob cut, green eyes, yellow hoodie, large black headphones around neck, simple white background, clean line art, cel shading, flat colors, no text, no logo, no watermark
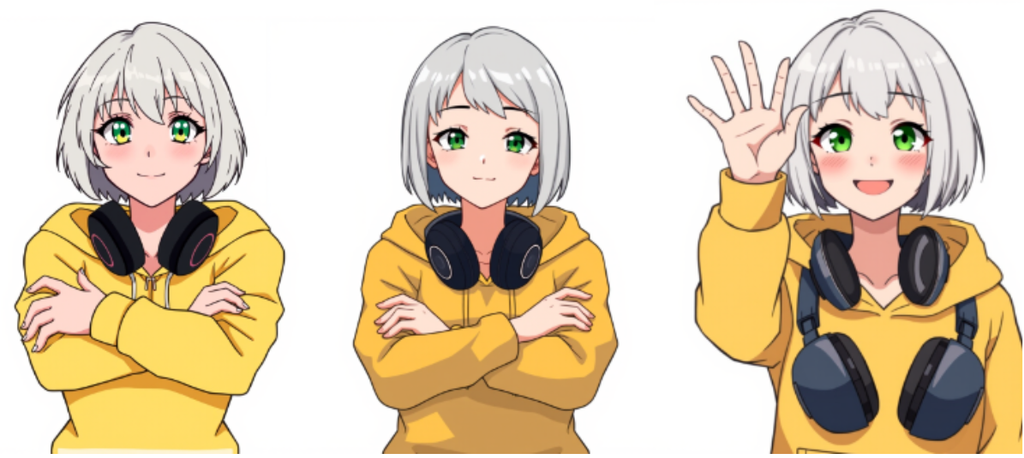
キャプション:ポーズの記述だけを変更したもの。左2枚が腕組み、右が手を上げるポーズです。手を上げるポーズはseedによって崩れることが多く、腕が欠けるなど破綻した画像は掲載していません。
腕組みは問題なく描かれました。しかし手を上げるポーズは、試したseedの多くで破綻します。反対側の腕が横へ伸びて手が消えたり、首にかけたヘッドホンがもう1組増えたりしました。「右手を上げる」と書いたのに左手が上がるケースもあり、左右の指示も安定しません。
体の動きが大きいほど崩れやすい、というのがここでの観察です。
使えるモデルは、性能より先にライセンスで決まる
そこで第3回で使ったOpenPose ControlNetの出番、と考えました。姿勢だけを外部から指定する仕組みです。
ところが、第3回で導入したControlNetはSD1.5向けで、FLUXでは動作しません。そしてFLUX向けのControlNetは、公式・コミュニティ版ともにFLUX.1 [dev]を前提に作られています。
本連載は掲載物の商用利用を前提に、商用利用を妨げない表示が確認できるものを選んでいます。FLUX.1 [dev]系のライセンスには生成物の扱いに関する条項もありますが、本連載ではモデル自体の利用が非商用に限られるものは使わない方針です。
この条件では、FLUX向けControlNetの選択肢がありませんでした。
モデルの性能で選ぶとライセンスが合わず、ライセンスで選ぶと機能が足りないということがありえます。 機能比較表を作る前に、使えるものと使えないものを仕分ける作業が要る、ということです。
同じ理由で、キャラクターや絵柄の特徴を追加学習させて反映する「LoRA」も今回は使っていません。本来は今回のような用途で有力な選択肢ですが、配布されているLoRAの多くは、何を学習素材にしたのかが明示されていません。本連載では、学習素材やライセンスが不明確なもの、特定作家・既存キャラクター・実在人物の再現を目的としたLoRAは使用しない方針です。
代わりに試したのが、写真を下絵として渡す「img2img」です。追加のモデルが不要なため、ライセンス確認の作業も増えません。
同じ設定値でも、使い方が変われば意味が変わる
img2imgへの変更は、ノードを3つ足して線を1本つなぎ替えるだけで済みます。
- 画像を読み込む:下絵の写真を読み込む
- 画像を拡大:1024×1024へ揃える(クロップはcenter)
- VAEエンコード:写真を、生成処理が扱える形式(潜在画像)へ変換する
そのうえで、Kサンプラーの「潜在画像」の入力を、「空の潜在画像」からVAEエンコードの出力へ差し替えます。ゼロから生成するか、下絵から始めるかの違いは、この1本の線だけです。
下絵には、筆者自身をスマホで撮影した写真を使いました。本連載では他人の画像や既存作品を入力素材に使わない方針のため、参照画像は自作に限定しています。なお、掲載画像では顔にモザイクをかけています。
ここで効いてくるのが、Kサンプラーのノイズ除去という設定です。値を下げるほど下絵の形や色が残り、1.00にすると下絵を無視してゼロから生成します。
そこで0.65、0.75、0.80と値を振ったのですが、結果はどれも写真の質感が強く残ったままでした。しかも少し値を上げると、今度は下絵を完全に無視した画像に戻ってしまいます。「ちょうどいい中間」が存在しないように見えました。
手がかりになったのは、0.75と0.80の出力が1ピクセルも違わない同じ画像だったことです。
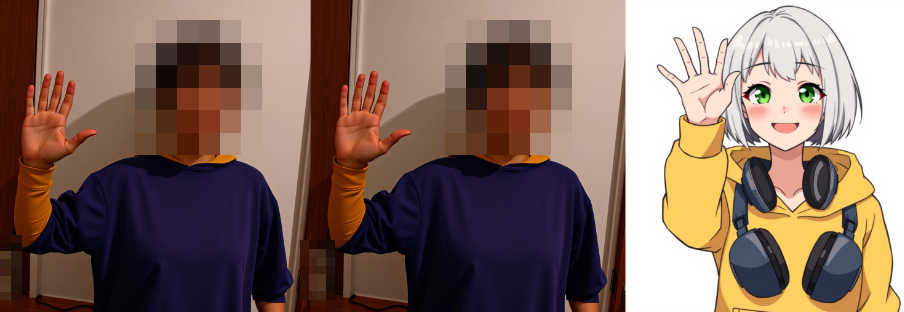
キャプション:steps 4で、ノイズ除去を0.75(左)、0.80(中央)にした結果。2枚は完全に同じ画像になりました。右は0.85以上に上げた例で、下絵はまったく反映されていません。
ComfyUIの仕様を確認すると、ノイズ除去の仕組みは次のようになっていました。まず「steps÷ノイズ除去」(小数点以下は切り捨て)の段数で描き直しの工程表を作り、その後ろからsteps回分だけを実行します。実行回数は常にsteps回で、ノイズ除去が決めているのは「工程表のどこから始めるか」です。
当時のstepsは4でした。これを当てはめると次のようになります。
| ノイズ除去 | 工程表の段数(4÷値) | 開始位置 |
| 0.65 | 6段 | 3段目から |
| 0.75 | 5段 | 2段目から |
| 0.80 | 5段 | 2段目から |
| 0.85〜1.00 | 4段 | 1段目から(1.00と同じ) |
0.75と0.80は同じ工程表の同じ位置から始まるので、結果が完全に一致したわけです。そして0.85以上は、すべて1.00と同じ処理になります。FLUXのような仕組みのモデルでは、1段目から始めると下絵の情報が完全にノイズで置き換わるため、下絵は結果に影響しません。「少し上げると下絵を無視する」と見えたのはこのためで、steps 4では0.80が下絵を生かせる上限でした。
第2回では、steps 2・4・8を比較して「4から増やしても大きな差はない」と判断していました。しかしimg2imgでは、stepsは生成時間だけでなく、ノイズ除去をどこまで細かく調整できるかも決めています。
そこでstepsを16へ増やし、ノイズ除去を0.80から0.98まで変えてみました。
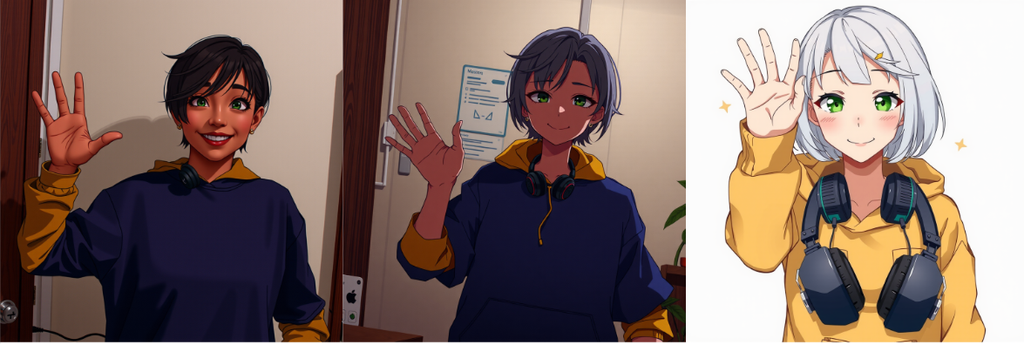
キャプション:stepsを16に増やしたうえで、ノイズ除去を変えた結果。左から0.88、0.94、0.96。この顔は筆者自身の顔そのものではありません。
今度は段階が見えました。0.80ではほぼ写真のまま。0.88で半分アニメ調になり、0.94では背景と髪色が写真に引きずられます。そして0.96で、指定したキャラクターの特徴がすべて戻り、腕の破綻もない画像になりました。
うまくいった値が、実は下絵を使っていなかった
これで解決、と考えたのですが、念のため0.75と0.80のときと同じ方法で確かめました。最終的に採用したseed 4015で、ノイズ除去0.96と1.00の出力を比べたのです。
結果は、1ピクセルも違わない同じ画像でした。
先ほどの仕組みをsteps 16に当てはめると、理由が分かりました。
| ノイズ除去 | 工程表の段数(16÷値) | 開始位置 |
| 0.80 | 20段 | 5段目から |
| 0.88 | 18段 | 3段目から |
| 0.94 | 17段 | 2段目から |
| 0.95〜1.00 | 16段 | 1段目から(1.00と同じ) |
0.96は1.00と同じ処理で、下絵は一切使われていませんでした。当初は「下絵から腕の位置だけを受け継いでいる」と考えていましたが、それも見かけ上のものです。腕の破綻が消えたのは下絵のおかげではなく、seed 4015でたまたま崩れない画像が出たためでした。
steps 16で下絵が効くのは0.94まで。その値では背景や髪色まで写真に引きずられ、その先は一気に下絵を無視する状態へ切り替わります。今回の写真とFLUX.1 Schnellの組み合わせでは、「姿勢だけを受け継ぐ」ちょうどいい値は見つかりませんでした。stepsをさらに増やせば刻みは細かくなりますが、今回は試していません。
ノードベース故の失敗の切り分け
この失敗を振り返ると、共通点があります。いずれも出力画像を眺めるだけでは原因が分からない種類のものでした。
| 失敗 | 疑った場所 | 切り分けに使った操作 |
| 髪色が毎回変わる | プロンプト → モデル | チェックポイントだけを差し替え、他は固定 |
| ノイズ除去が効かない/効いたように見える | 設定値の意味 | 出力の完全一致(0.75と0.80、0.96と1.00)から逆算 |
これとは別に、FLUX向けControlNetがライセンスの条件で使えないという制約にもぶつかりました。こちらは失敗ではなく、検証を始める前に確認できる種類の問題です。
ComfyUIでは、モデル、プロンプト、サイズ、ステップ数、ノイズ除去、素材の流れが、すべて同じ画面に並んでいます。そのため「1つだけ変えて、他は固定する」という比較が自然にできます。
ノイズ除去の2つの件も、確認に使ったのは値を1つ変えて出力を並べる、という単純な操作だけでした。
ここが、今回の検証で感じたComfyUIの実務的な価値でした。つまり、きれいな画像が出ることではなく、思い通りにならなかったときに原因を特定できることです。うまくいっているうちは差が出ませんが、うまくいかなくなった瞬間に差が出ます。
それでも「同じキャラ」は完成しなかった
最終的な条件は次の通りです。
- モデル:FLUX.1 Schnell FP8
- 画像サイズ:1024×1024
- steps:16
- CFG:1.0
- sampler:euler
- scheduler:simple
- ノイズ除去:0.96(前述の通り1.00と同じ処理で、下絵は使われていません)
- seed:4015
- プロンプト:前掲の3種(立ち姿・手を上げる・腕組み)
この条件で、腕組み、手を上げる、立ち姿の3枚を生成しました。ワークフロー上はimg2imgを経由していますが、中身はプロンプトだけの生成と同じです。基準キャラクター(seed 4003)と見比べた結果は次の通りです。
| 項目 | 腕組み | 手を上げる | 立ち姿 |
| 顔立ち・絵柄 | やや繊細 | 柔らかく、かわいらしい方向 | 基準に近い |
| 髪型 | 一致 | 一致 | 一致 |
| 髪色 | 一致 | 毛先に紫が混ざる | 一致 |
| 目の色 | 一致 | 一致 | 一致 |
| 衣装 | 一致 | 一致 | 一致 |
| ヘッドホン | 首にかける/ピンクのリング | 頭と首に2組 | 首にかける/白いライン |
| 指定外の要素 | リュックの肩ひも | リュックの肩ひも、効果線 | 肩ひもらしき線 |
3枚とも手や腕は自然に描かれ、髪型、目の色、衣装という基本的な特徴も維持されました。
一方、装飾の細部は固定できていません。ヘッドホンのラインの色は3枚とも異なり、手を上げるカットでは頭にも1組増えています。髪の毛先の色にも違いが出ました。基準キャラクターを選ぶ段階で問題になっていたリュックの肩ひもも、最後まで消えていません。
「読者から見て同じ人物の別カットと認識できるか」を基準にすれば、今回の3枚は成立していると言えそうです。
ただし、装飾や絵柄まで揃った状態で量産できる水準ではありません。連載の案内役として毎回登場させるなら、生成後に人の手で修正するか、別の仕組みを足す必要があります。
ワークフローの積み上げ
目標だった「同じキャラを作り続ける」は達成できませんでした。ただ、この検証から次回以降そのまま使えるものが3つ残っています。
1つ目は、保存したワークフローです。ゼロから生成する構成と、下絵から始める構成の2つを保存しました。ComfyUIは生成したPNGをキャンバスへドラッグするだけでワークフローを復元できるため、採用画像そのものが設定ファイルを兼ねます。
2つ目は、確定した生成条件とプロンプトです。上に挙げた条件を記録しておけば、同じ条件から別案を作れます。
3つ目は、ライセンスの記録です。使用したモデル、確認日、ライセンス表示のスクリーンショットを残しました。使えなかったモデルとその理由も記録しています。
1枚の画像は使い捨てですが、この3つは繰り返し使えます。第2回でも「重要なのは数値自体より、条件を固定し、比較し、記録できること」と書きましたが、今回はそれが失敗の側でも成立しました。どこで失敗したかを記録できれば、同じところで止まらずに済みます。
モデルのライセンスと、生成後の確認
今回使用したモデルと、確認したライセンス表示は以下の通りです。
| モデル | 配布元 | ライセンス表示 |
| FLUX.1 Schnell FP8 | Hugging Face(Comfy-Org配布版) | Apache License 2.0 |
| Stable Diffusion v1.5(v1-5-pruned-emaonly) | Hugging Face(stable-diffusion-v1-5) | CreativeML OpenRAIL-M |
加えて、今回は「使わなかったモデル」の記録にも時間を使いました。FLUX向けControlNetは、公式のCanny・DepthがFLUX.1 [dev]版として公開されており、コミュニティ版のControlNet Unionも非商用ライセンスの表示でした。
権利面では、次の3点を確認しています。
まず、下絵に使った写真はすべて筆者自身を撮影したものです。他人の写真、SNS画像、既存作品は入力していません。
次に、写真を下絵にすると、意図せず実在人物に近い出力が生じ得る点です。実際、ノイズ除去が低い条件では、筆者本人の面影が残る写真風の人物画像が生成されました。他人の写真を使えば、その人に似た画像が生成される可能性があるということです。
3つ目は、SD1.5の検証中に、指定していないストック写真サービスの透かしが生成された件です(見出し『プロンプトを直しても直らないなら、モデルを疑う』で掲載した比較画像の赤枠部分)
。モデルのライセンスが商用利用を認めていても、出力に第三者のマークが混入する可能性はあるということになります。
Cannyの検証でも意図しない文字やマークが描かれていました。第2回で意図しない文字が生成された件と同様、公開前に人が確認する工程は省けません。
生成物については、既存IP、実在人物、企業ロゴ、特定作家の作風、既存作品に強く似ていないかを公開前に確認しました。
同じキャラを作り続ける難易度
当初の問いへの答えは、1枚のキャラクターを作ることと、同じキャラクターを作り続けることは、別の作業だったというものです。
1枚目は、プロンプトとモデルが噛み合えば比較的すぐ作れます。しかし2枚目以降は、seedやポーズが変わるたびに、どこかの細部が揺れます。今回の3枚も、ポーズの破綻を避けられたのはseedの当たりによるもので、狙って再現できる状態ではありません。
現時点での評価としては、「ComfyUIで同じ設定の人物を複数枚作ることはできる。ただし同一人物の別カットとして通用させるには、生成後の選別や修正を前提に考える必要がある」というあたりが近そうです。
次回は参照画像から一貫性を高める
今回はプロンプトと下絵で、キャラクターの一貫性をどこまで作れるか試しました。基本的な特徴は揃った一方、装飾や絵柄の細部は揃いきっていません。
次回は、参照画像から色味や雰囲気を受け継ぐ仕組みを試す予定です。本連載の方針に沿って使える手段があるかをライセンスから確認したうえで、今回残った細部のばらつきをどこまで抑えられるか、そしてワークフローとして保存・共有し、チーム内で再利用できる形にまとめられるかを検証します。